

2026年9月15日,一家名为TypeSafe AI的公司宣布结束隐身模式,同时发布了一个叫Jev的模型。接下来的24小时里,Vercel约13%的付费团队开始使用它。Vercel官方把这次发布称为其历史上采用最快的发布之一。Cloudflare、LangChain、Langfuse也在几天内陆续提供了原生支持。
一个模型被基础设施平台迅速接入,通常意味着它解决了一个足够具体、足够痛的问题。但Jev这个东西,第一眼看上去并不像人们熟悉的AI。它不会写诗,不会总结文档,连一段完整的自然语言回答都不生成。它的输出是一组数字:概率、分数、置信度。
这引出了一个问题:一个“不说话”的模型,为什么让开发者这么兴奋?
要回答这个问题,需要先搞清楚Jev是什么,再去看它实际做了什么、和主流模型有什么不同,以及它的边界在哪里。
一个不做文本生成的模型
Jev的官方定义是“系统一模型”(System One Model)。这个词来自心理学家丹尼尔·卡尼曼在《思考,快与慢》里提出的双系统理论:系统一是快思考,直觉式的,不假思索地做出判断;系统二是慢思考,需要推理和计算。TypeSafe用这个词命名,是在明确划清边界,Jev只做系统一的事,不做系统二的事。
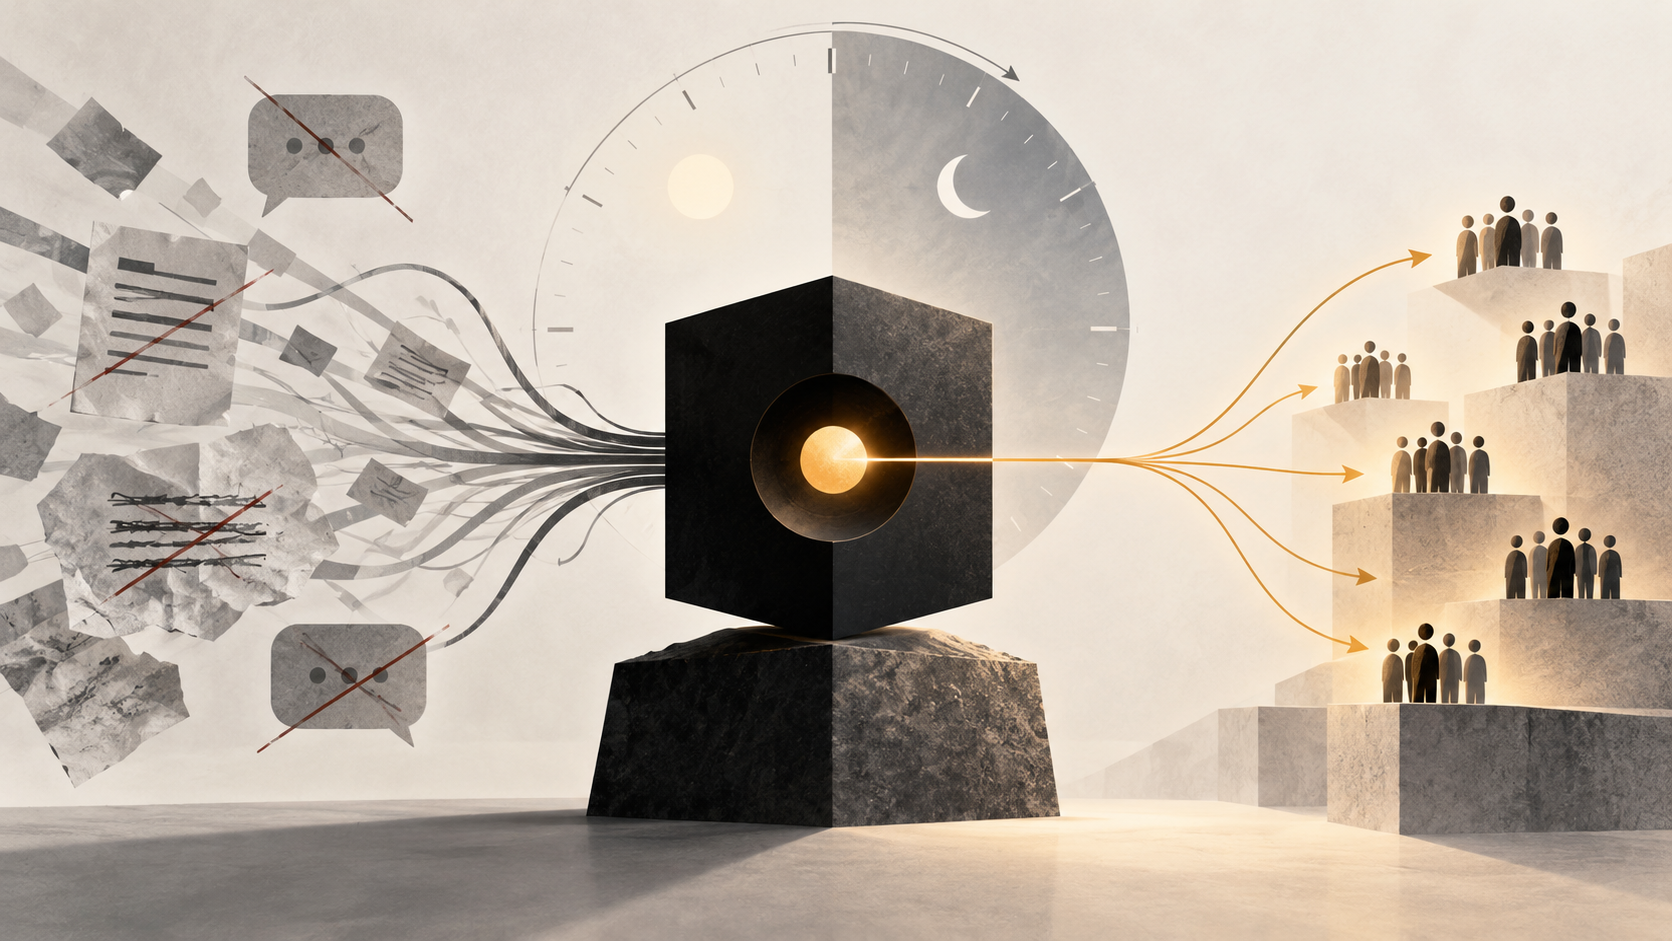
更准确地说,Jev不是一个传统意义上的大语言模型。大语言模型的工作方式是自回归生成,一个token接一个token地吐出文本。Jev不做这件事。开发者给它输入一个state,也就是当前的状态或上下文,再给它一组类型化的问题,它并行地输出结构化的概率和置信度分数。这些问题的类型只有三种:Noul,是非判断;Choice,多选;Score,评分。输出严格符合预定义的格式,没有自由文本,没有“让我想想”,只有数字。
这种设计对应着一个很具体的场景:软件需要程序化地做大量快速判断。比如判断一封邮件是不是垃圾邮件,判断用户输入是否涉及违规内容,判断一个请求该走哪条路由。传统做法是调用大语言模型,让它生成文字回答,再解析这段文字,提取出想要的结论。这中间有延迟、有解析失败的风险、有大量的token消耗去生成那些最终可能被丢弃的解释性文字。Jev的做法是跳过生成,直接给出判断。
开发这家公司的,是一个有足够分量的人。TypeSafe AI的创始人Diogo Almeida是前OpenAI研究员,也是InstructGPT和RLHF(基于人类反馈的强化学习)的核心共同发明人。这两项技术是ChatGPT和GPT-4能够遵循人类指令的基础。Almeida在2024年离开OpenAI,和联合创始人Erik Gafni、Sasha Sheng一起创立了TypeSafe AI,经历了两年隐身开发,在2026年9月15日同时宣布了产品发布和4000万美元种子轮融资,领投方是DCVC。
Jev这个名字同样有来源。它出自19世纪经济学家威廉·斯坦利·杰文斯提出的“杰文斯悖论”:当某种资源的使用成本下降时,它的总消耗量反而会上升,而不是下降。19世纪,蒸汽机效率提升降低了煤炭消耗强度,结果煤炭总需求反而爆发式增长。TypeSafe取这个名字,是在说明自己的商业预期:当AI决策的成本低到某种程度,软件里嵌入AI决策的总需求会大幅增长,而不是停留在今天的少数高价值场景。
理解了这些背景,Jev的定位就开始清晰了:这不是一个更好的聊天机器人,而是一个专门用来做判断的组件。
快多少,便宜多少
Jev引发关注的核心原因很直接:在它擅长的任务上,它快得明显,便宜得明显。
先看官方口径。TypeSafe宣称Jev在分类等系统一任务上,比同类大语言模型快40到200倍,端到端延迟70到500毫秒;成本低40到400倍。计费方式也特别:输入token按每百万token 0.042美元计费,输出token免费。常规大语言模型通常是输入输出都计费,而且输出的单价往往比输入更高。
官方数字需要打折看。但第三方测试给出的数据,方向是一致的。
Vercel软件工程师Pranit Sharma做过一个直接对比:用Jev替换OpenAI的模型运行安全命令分类器,速度提升了5到18倍,准确率还更高。Bryo AI的CTO Nikhil Mudholkar用Jev和Gemini分类商业邮件,结果是Gemini的准确率略高,但成本高10到20倍,而且Jev返回的是经过校准的概率分数,更适合自动化工作流里的后续判断。
更具象的数字来自开发者Tyler Folkman。他做了一次实验:运行60个AI Agent模拟村庄,让它们做了一整天决策,总共做出13200个决策。在Jev上,这一天跑下来的实际成本是0.35美元。按前沿模型的计价方式模拟同样的决策量,成本是37.64美元。折算下来,Jev的单次决策成本大约是0.0000265美元,前沿模型是0.00285美元,差距约107倍。
107倍这个具体数字值得注意,因为它落在官方宣称的40到400倍区间之内。这不是说所有场景都会便宜107倍,差距会随任务、模型和计价方式变化。但这个数据点说明,在特定的自动化决策场景下,成本差一个数量级以上是真实存在的,不是营销修辞。
速度上的差异机制也值得说清楚。传统大语言模型处理一个分类任务时,要生成一长串token,哪怕最后有效的判断只是“安全”或者“不安全”两个词。生成过程是自回归的,token逐个产出,延迟随输出长度线性增长。如果还要生成解释性文字,比如“我认为这是安全的,因为……”,成本更高。Jev砍掉了整个生成过程,并行地计算各个选项的概率,一步到位。这意味着延迟主要由输入长度决定,与输出无关。输出token免费这个定价,本质上是在承认:它的推理成本结构里,输出侧的负担极小,小到可以免费。
速度和成本之外,还有一点常被忽略但同样重要:输出的确定性。大语言模型生成自由文本,总有解析失败的风险。模型可能输出“安全!”,也可能输出“This is safe.”,可能在JSON外面加注释,可能突然开始长篇大论。开发者通常需要一层额外的解析和容错代码来处理这些不确定性。Jev的输出符合严格的schema,格式上不会有意外。TypeSafe把这点总结为“类型安全”,并由此命名了公司。
但“类型安全”和“无幻觉”之间有一个重要的边界需要划清。
不是替代品,是补充组件
Jev在宣传中被描述为“无法幻觉”。这个说法需要准确理解。
官方对这句话的解释是:Jev的输出严格符合预定义的JSON schema或选项,不会生成格式上无法解析的内容。所以“无法幻觉”指的不是判断永远正确,而是输出格式永远确定。一个判断本身可以错,比如把不是垃圾邮件的邮件标成垃圾邮件,但它不会在输出格式上出现意外,不会在JSON里多出一段自由文本把解析器搞崩。
这个区分对理解Jev的行业位置很重要。它不是一个可以替换大语言模型的东西。官方自己反复强调,Jev不是LLM的drop-in replacement。你没法用它聊天,没法用它写文章,没法问它“我该不该接受这个offer”。它做的事情只有一件:在一个明确的任务上,给出校准后的概率。对外表现形式更像一个函数调用,一个“前沿智能函数调用”(frontier-intelligence function call),嵌在软件工作流里,在需要快速判断的地方被调用。
这和主流大语言模型的技术路线构成对比。当前主流模型经过RLHF或RLVR训练,优化的是对人类偏好或可验证奖励的匹配,输出是自回归生成的自然语言。这种机制在开放式任务里强大,但在需要高频、低延迟、低成本的判断任务上,有两个代价:一是慢,二是贵,还有一个附带问题是置信度往往过度自信,模型说“我有95%把握”的时候,准确率通常达不到95%。
Jev换了一条路。TypeSafe把它采用的训练方法称为“校准决策强化学习”(RLCD,Reinforcement Learning for Calibrated Decisions)。核心优化目标不是“让输出的文本更像人类”,而是“让输出的置信度与准确率严格对应”。高置信度必须对应高准确率,不能说“95%把握”但只有70%的准确率。这一点在自动化工作流里特别重要,因为下游代码会根据概率分数决定是否采取行动,分数不可靠,自动化就是一纸空文。Bryo AI测试中提到的“真实校准概率”,指的就是这个特性。
训练数据方面,TypeSafe宣称完全使用合成数据,结合自研的并行采样器,放弃了字符串生成。这让Jev在架构上与主流LLM有实质差异。但具体是什么架构,TypeSafe没有公开。
这种对底层架构的沉默,在网上引发了讨论和怀疑。Reddit上有开发者指出,类似的非自回归概率预测架构,开源社区一年前就有实现。有人推测Jev可能基于某个开源权重的大语言模型构建,在其上加了专门的分类层。发布后不久,社区就出现了OpenJev这样的开源项目,基于Qwen3.5-4B等模型读取logits,近似复刻Jev的行为。
这些讨论目前没有官方证实。TypeSafe没有公开Jev是否基于某个开源模型微调,也没有公开并行采样器的具体实现。能确认的是,Jev的训练方法RLCD和合成数据是TypeSafe自己的说法,底层细节仍然是个黑箱。
它不擅长的事
TypeSafe在官方文档里列了一份清单,标题叫Jaggedness,列出Jev 1.13这个版本已知的失败模式。这份清单的坦诚程度在AI厂商里不常见。
不讲修辞地说,它对很多事情不擅长。数学计算不行,计数不行,日期比较容易出错。它不能处理十六进制颜色值这种间接比较。Score评分的数值校准在不同等级之间会变弱。一句话里出现双重否定或者多跳间接引用,准确率会下降。更重要的是,它没有任何可解释性:只返回一个概率数字,不提供任何自然语言解释,不会告诉你“为什么是85%”。
这些不是偶然的bug,而是这种技术路线的内在限制。放弃自然语言生成,意味着也放弃了用语言表达推理过程的能力。系统一式的直觉判断,本来就不擅长需要多步推理的任务。这也是为什么Jev被定位为一个组件而不是一个完整的智能体,它需要被放在更大的软件系统里,由写代码的人来决定在什么时候调用它、如何解释它的输出、失败时如何兜底。
理解这份限制清单,再去读官方的性能宣称,就能形成一个接近事实的画面:Jev在分类、路由、护栏这类边界明确的判断任务上,确实能提供比传统LLM快一个数量级、便宜一个数量级且格式确定的输出;但一旦任务变得复杂,需要计算、需要推理、需要解释,它的可靠性会明显下降,而且它自己不知道什么时候会错。
从目前公开的第三方测试看,所有数据都来自特定任务的短期对比,没有看到Jev在复杂长链路企业级工作流里连续运行数月的稳定性数据。Vercel的接入数据说明它被迅速试用,但不能推导出长期留存和真实故障率。输出token免费的商业模式能持续多久,TypeSafe也没有给出解释。
为什么是现在
回到开头的问题:为什么一个不说话、只做判断的模型,会在发布24小时内被大量开发者接入?
一个直接的原因是,它解决的痛点非常具体。软件自动化工作流里需要大量结构化判断,这就是Vercel这类平台及其用户最常面对的场景。Vercel团队测试它在安全命令分类上的表现后接入,说明这足够实用。Cloudflare做边缘推理,LangChain做Agent框架,它们各自都能从低延迟、低成本、类型安全的判断能力里受益。
更深一层的原因是,AI行业正走到一个点:大语言模型的通用生成能力已经非常强,但把它塞进软件工作流时,速度、成本、格式不确定性这三件事成了瓶颈。Jev是这个瓶颈的一种解法。它不代表什么颠覆性的智能飞跃,更像是一次范围收窄换来的成本结构和输出可靠性。
这也解释了它的名字。随着单个决策的成本降低,软件里嵌入AI决策的地方会越来越多,每一个地方都是一个调用点。那些以前因为太贵而用不起AI的地方,现在有了一个新的选项。
不过,Jev的真实长期表现还远未定论。底层架构不公开,长期生产的故障率没有数据,商业模式的可持续性不确定,社区的复刻项目也在快速跟进。但这些不确定性本身也说明了一件事:这个方向正在被认真对待。一个不做文本生成、只做结构化判断的模型,能在2026年9月引发这样的讨论和接入速度,说明AI模型正在从“全能生成”往“特定用途的分化”迈出实质性的一步。Jev不是终点,但它是那条分化路径上一个值得看的坐标。